Развитие генеративного искусственного интеллекта постепенно упирается не только в возможности алгоритмов, но и в физические ограничения вычислительной инфраструктуры. Современные большие языковые модели, системы генерации изображений, рекомендательные алгоритмы и мультимодальные нейросети требуют огромного количества операций над матрицами, большого объема памяти и чрезвычайно быстрого обмена данными между тысячами вычислительных устройств. Именно поэтому специализированные ускорители становятся одним из ключевых элементов современной ИИ-инфраструктуры. В экосистеме Google такую роль выполняют Tensor Processing Units, или TPU.
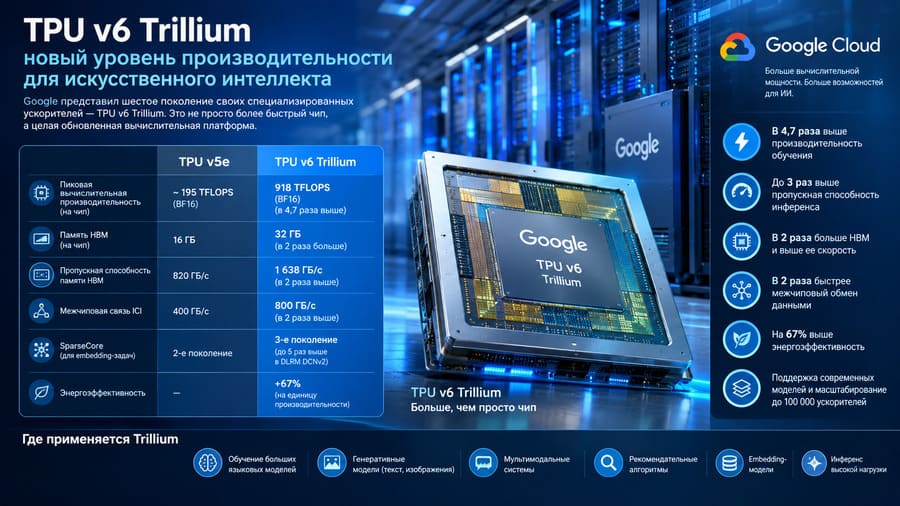
Шестое поколение этой архитектуры получило название Trillium и стало развитием предыдущих решений Google Cloud, прежде всего TPU v5e. Компания представила Trillium в мае 2024 года, а в декабре того же года новая платформа получила статус общей доступности для клиентов Google Cloud. По заявлению Google, в сравнении с TPU v5e Trillium обеспечивает более чем четырехкратный прирост производительности обучения, до трехкратного увеличения пропускной способности при инференсе, 4,7-кратный рост пиковой вычислительной производительности на чип и увеличение энергоэффективности примерно на 67 процентов. При этом удвоены емкость и пропускная способность высокоскоростной памяти HBM, а пропускная способность межчипового соединения ICI также увеличена в два раза.
Эти цифры важны не только как демонстрация более быстрого процессора. Основное отличие Trillium заключается в комплексной модернизации всей вычислительной системы. Google увеличила вычислительную плотность, ускорила работу памяти, расширила возможности обмена данными между TPU и добавила специализированный блок SparseCore третьего поколения. В результате ускоритель рассчитан не просто на выполнение большего числа операций в секунду, а на более эффективную работу с современными нейросетями, где вычисления, память и межчиповая коммуникация тесно связаны между собой.
Что такое TPU и зачем Google создает собственные ускорители
Tensor Processing Unit — специализированный процессор, разработанный Google прежде всего для задач машинного обучения. В отличие от универсального центрального процессора, TPU не пытается одинаково хорошо выполнять любые типы программ. Его архитектура ориентирована на операции, характерные для нейронных сетей, прежде всего на массовое умножение матриц и обработку тензоров.
Такой подход особенно важен для глубокого обучения. Большая часть вычислений в трансформерах, сверточных сетях и других современных архитектурах сводится к огромному количеству операций над массивами чисел. Если процессор спроектирован с учетом именно таких операций, можно увеличить вычислительную плотность и одновременно снизить количество вспомогательных операций, необходимых универсальному оборудованию.
Google развивает TPU более десяти лет. Специализированные ускорители использовались внутри компании для различных сервисов, а впоследствии стали доступны клиентам Google Cloud. В шестом поколении акцент сделан на наиболее ресурсоемких современных сценариях: обучении больших языковых моделей, тонкой настройке, генеративных моделях, инференсе и системах с большим количеством embedding-операций.
Trillium против TPU v5e: главное отличие в вычислительной мощности
Самая заметная характеристика нового поколения — рост пиковой вычислительной производительности. Согласно данным Google, один чип Trillium обеспечивает 4,7 раза больше пиковой вычислительной мощности, чем TPU v5e. Такой скачок стал результатом увеличения размеров матричных вычислительных блоков MXU и повышения тактовой частоты.
Но пиковые FLOPS сами по себе не определяют реальную скорость обучения нейросети. Чтобы ускоритель мог использовать вычислительные блоки на высокой загрузке, ему необходимо быстро получать данные из памяти. Если вычислительная часть системы способна выполнять операции быстрее, чем память поставляет необходимые параметры и активации, часть потенциальной производительности остается невостребованной. Поэтому Google одновременно с увеличением вычислительной мощности существенно переработала подсистему памяти.
В Trillium применяется 32 ГБ HBM на чип с пропускной способностью 1,638 ТБ/с, а межчиповая коммуникация обеспечивает двунаправленную полосу до 800 ГБ/с на TPU. В конфигурации v6e один TPU-чип содержит один TensorCore с двумя матричными блоками MXU, векторным и скалярным блоками.
Почему увеличение HBM так важно для больших языковых моделей
Одна из главных проблем современных нейросетей заключается в том, что их параметры занимают огромное количество памяти. Увеличение числа параметров модели само по себе не гарантирует улучшения качества, однако крупные модели требуют все больше памяти для хранения весов, промежуточных результатов и дополнительных структур, необходимых во время инференса.
Особенно важен в этом отношении KV-cache, используемый трансформерными моделями при генерации последовательностей. Чем длиннее контекст и чем больше одновременно обрабатывается запросов, тем больше памяти требуется для хранения ключей и значений attention-механизма. Поэтому удвоение емкости HBM в сравнении с TPU v5e имеет практическое значение не только при обучении, но и при обслуживании больших моделей.
Google прямо связывает увеличение HBM с возможностью эффективнее работать с моделями, содержащими больше весов, а также с более крупными KV-кэшами. Одновременно была удвоена пропускная способность HBM, поэтому речь идет не только о большем объеме памяти, но и о более высокой скорости обмена данными между вычислительными блоками и памятью.
Для разработчика это означает, что увеличение размера модели не обязательно приводит к пропорциональному падению производительности. Чем лучше сбалансированы вычислительная мощность и память, тем меньше вероятность, что ускоритель будет простаивать в ожидании данных.
Удвоенная скорость межчипового обмена
Современная нейросеть редко работает на одном ускорителе. При обучении больших моделей параметры, данные и вычисления распределяются между множеством чипов. Поэтому скорость связи между ускорителями становится практически такой же важной характеристикой, как производительность отдельного процессора.
В Trillium пропускная способность Inter-Chip Interconnect, или ICI, увеличена в два раза по сравнению с TPU v5e. Это позволяет быстрее передавать данные между ускорителями при распределенном обучении. Особенно существенным такой прирост становится для моделей, где вычислительные задачи сопровождаются большим количеством коллективных операций между устройствами.
Архитектура v6e предусматривает до 256 TPU-чипов в одном pod с высокоскоростным соединением. На уровне одного pod используется топология 2D torus, а общий объем двунаправленной пропускной способности ICI для pod достигает 102,4 ТБ/с.
Это принципиально важно для масштабирования. Если тысяча ускорителей соединены медленной сетью, добавление новых чипов не дает линейного роста производительности: устройства начинают тратить все больше времени на ожидание обмена данными. Быстрый специализированный интерконнект уменьшает эту проблему и позволяет распределять вычисления на гораздо большее количество узлов.
Trillium и обучение больших языковых моделей
Большие языковые модели предъявляют одновременно высокие требования к вычислительным блокам, памяти и коммуникациям. Во время обучения нейросеть многократно проходит по огромным массивам данных, вычисляя прямой и обратный проходы и обновляя миллиарды параметров. При распределенном обучении часть параметров и вычислений размещается на разных ускорителях, поэтому устройства постоянно обмениваются промежуточными результатами.
Именно поэтому преимущество Trillium нельзя сводить к одной цифре в 4,7 раза. Для реальной модели важна совокупность улучшений. Быстрее выполняются матричные операции, увеличивается пропускная способность HBM, расширяется межчиповая связь, а специализированный SparseCore берет на себя отдельный класс операций. В результате повышается вероятность того, что вычислительные ресурсы будут эффективно загружены на протяжении всей задачи.
В опубликованных Google тестах Trillium показал более чем четырехкратное увеличение производительности обучения для ряда моделей, включая Gemma 2-27B, MaxText Default-32B и Llama 2-70B, по сравнению с TPU v5e. Для некоторых других конфигураций, включая Llama 2-7B и Gemma 2-9B, прирост превышал трехкратный уровень. Это важно воспринимать именно как результаты конкретных тестовых сценариев, а не как универсальный коэффициент ускорения любой нейросети.
До трех раз больше производительности при инференсе
Обучение — лишь одна сторона работы ИИ-системы. После завершения обучения модель должна отвечать на запросы пользователей, генерировать текст, изображения или другие данные. Этот процесс называется инференсом, и для коммерческих систем именно он может стать одной из наиболее затратных стадий эксплуатации.
Google указывает, что Trillium способен обеспечивать до трехкратного увеличения пропускной способности инференса по сравнению с TPU v5e. При этом конкретный результат зависит от модели, размера батча, длины последовательности, режима точности вычислений и особенностей программной реализации.
Показатель особенно интересен для генеративных приложений. Если один ускоритель способен обработать больше запросов за единицу времени, инфраструктуре требуется меньше вычислительных ресурсов для обслуживания того же пользовательского потока. В облачной среде это непосредственно связано с эксплуатационными расходами, а также с возможностью обслуживать пики нагрузки без пропорционального увеличения числа машин.
Новый SparseCore для моделей с embedding
Одной из особенностей Trillium стало третье поколение SparseCore — специализированного блока для операций, связанных с embedding. Такие операции широко используются в рекомендательных системах, поисковом ранжировании и других моделях, где необходимо работать с огромными таблицами признаков и выполнять нерегулярные обращения к данным.
Обычные матричные вычисления хорошо ложатся на традиционные тензорные ускорители, однако embedding-задачи могут иметь совершенно другую структуру. Здесь важны не только арифметические операции, но и эффективный доступ к разреженным данным, операции scatter-gather, суммирование сегментов и различные формы динамического перераспределения информации.
Google сообщает, что третье поколение SparseCore в Trillium дает двукратное улучшение производительности embedding-интенсивных моделей и до пятикратного улучшения в тестах DLRM DCNv2 по сравнению с предыдущими решениями.
Это показывает важную тенденцию в проектировании ИИ-ускорителей: универсального вычислительного блока недостаточно для всех типов машинного обучения. Разные классы нейросетей требуют разных аппаратных механизмов, и Trillium сочетает массивные тензорные вычисления с отдельным специализированным ускорителем для разреженных операций.
Энергоэффективность стала не менее важна, чем скорость
Рост производительности современных ИИ-систем сопровождается стремительным увеличением энергопотребления дата-центров. Чем больше ускорителей используется для обучения модели, тем выше расходы не только на электричество, но и на охлаждение, питание, инфраструктуру и эксплуатацию оборудования.
Google заявляет, что Trillium более чем на 67 процентов эффективнее TPU v5e по энергопотреблению при сопоставлении соответствующего показателя производительности. Это не означает, что отдельный Trillium-чип обязательно потребляет на 67 процентов меньше электроэнергии в любой рабочей нагрузке. Речь идет об эффективности выполнения вычислений, поэтому показатель следует рассматривать в контексте производительности на единицу энергии.
Такой подход становится особенно важным при масштабных задачах. Разница между двумя поколениями ускорителей может казаться небольшой при работе одной машины, но при использовании десятков тысяч чипов даже относительно небольшое улучшение эффективности способно существенно изменить суммарные требования к электропитанию и охлаждению дата-центра.
Производительность на доллар
Для облачной инфраструктуры абсолютная скорость — далеко не единственный критерий. Компании интересует стоимость выполнения конкретной задачи: например, сколько стоит обучение модели определенного размера или обработка миллиона пользовательских запросов.
По данным Google Cloud, Trillium обеспечивает до 2,1 раза более высокую производительность на доллар по сравнению с TPU v5e при обучении плотных больших языковых моделей и до 2,5 раза по сравнению с TPU v5p в определенных сценариях обучения. Google также приводит показатели улучшения экономической эффективности для инференса.
Подобные значения нельзя автоматически переносить на любую нейросеть. Экономическая эффективность зависит от архитектуры модели, длительности работы, загрузки ускорителей, стоимости хранения и передачи данных, размера батча и множества других параметров. Однако сама стратегия Trillium очевидна: Google стремится увеличить не только количество операций в секунду, но и количество полезной работы, которую можно выполнить на единицу затрат.
Почему масштабирование до тысяч и десятков тысяч чипов имеет значение
Один из главных вызовов эпохи больших моделей — необходимость объединять огромное количество ускорителей в единую вычислительную систему. Trillium способен масштабироваться на уровне pod до 256 чипов, а затем использовать Multislice и сетевую инфраструктуру Google для построения гораздо более крупных кластеров.
Google указывает, что инфраструктура Trillium способна масштабироваться до сотен pod и десятков тысяч ускорителей в рамках одного вычислительного комплекса. В документации Google Cloud также заявлена возможность использования до 100 000 Trillium-чипов в одной сетевой инфраструктуре Jupiter с совокупной пропускной способностью двоичного сечения до 13 Пбит/с.
Для ИИ это имеет принципиальное значение. Большая модель может быть разделена между множеством устройств, причем каждый ускоритель становится частью единой вычислительной системы. Чем быстрее работают межсоединения и чем эффективнее программное обеспечение управляет распределением задач, тем ближе итоговая производительность к теоретическому суммарному потенциалу оборудования.
Почему одной аппаратной мощности недостаточно
Современный ИИ-ускоритель нельзя рассматривать изолированно от программного стека. Даже самый производительный чип не даст ожидаемого результата, если компилятор не умеет эффективно распределять операции, библиотека не использует аппаратные возможности, а система управления кластером плохо масштабирует нагрузку.
Trillium интегрируется с программными инструментами Google для машинного обучения. Google указывает поддержку JAX, PyTorch через XLA и TensorFlow, а также развитие совместимости с экосистемой Hugging Face. Это позволяет переносить существующие модели на новое поколение ускорителей без полного переписывания вычислительной логики.
Особенно важную роль здесь играет XLA — компиляторный слой, который преобразует операции высокоуровневых ML-фреймворков в более эффективное представление для специализированного оборудования. Для TPU такой уровень абстракции позволяет разработчику работать преимущественно с моделью, а не вручную управлять каждым аппаратным блоком.
Trillium уже использовался для Gemini
Показательным примером практического применения нового оборудования стало использование Trillium при обучении Gemini 2.0. Google сообщила о применении шестого поколения TPU для обучения этой модели еще до предоставления Trillium клиентам Google Cloud. В декабре 2024 года платформа стала общедоступной для пользователей облака.
Этот факт показывает важную особенность собственной аппаратной экосистемы Google. Компания контролирует значительную часть цепочки — от проектирования ускорителя и сетевой инфраструктуры до компиляторов, библиотек и собственных моделей. Такая вертикальная интеграция позволяет оптимизировать оборудование под характерные для Google рабочие нагрузки и одновременно адаптировать программное обеспечение под конкретную архитектуру.
Чем Trillium принципиально отличается от простого увеличения числа ускорителей
Можно предположить, что четырехкратный рост вычислительной мощности можно получить простым добавлением в четыре раза большего количества старых чипов. На практике это не так. При масштабировании возникает проблема обмена данными. Чипы должны получать параметры, передавать результаты коллективных операций и синхронизироваться между собой.
Если увеличить только количество вычислительных блоков, но оставить память и коммуникации без изменений, система быстро столкнется с эффектом «бутылочного горлышка». Ускорители будут иметь высокий теоретический потенциал, но значительную часть времени проводить в ожидании данных. Именно поэтому в Trillium одновременно увеличены вычислительная мощность, HBM и ICI.
По сути, Google модернизировала сразу три уровня системы: вычисления, память и сеть. Дополнительный специализированный SparseCore расширяет этот баланс еще на один класс задач. Именно комплексность изменений объясняет, почему прирост производительности реальных моделей может быть существенно выше, чем простое увеличение производительности одного вычислительного блока.
Технические характеристики TPU v6e Trillium
В актуальной документации Google Cloud для TPU v6e, под которым Trillium обозначается на технических поверхностях, указана пиковая производительность 918 TFLOPS на чип для BF16 и 1836 TOPS для INT8. Каждый чип оснащен 32 ГБ HBM с пропускной способностью 1638 ГБ/с. Двунаправленная пропускная способность межчиповой связи составляет 800 ГБ/с. В pod можно объединить 256 чипов, что дает теоретическую пиковую производительность BF16 около 234,9 PFLOPS на pod.
Эти характеристики нужно воспринимать как параметры аппаратной платформы, а не как гарантированную скорость конкретной нейросети. Реальная производительность зависит от того, насколько хорошо модель использует MXU, насколько часто обращается к HBM, какой объем данных приходится передавать между чипами и насколько эффективно программный стек выполняет распределение вычислений.
Какие задачи особенно подходят для Trillium
Архитектура шестого поколения рассчитана прежде всего на большие нейросетевые нагрузки. К ним относятся обучение и дообучение больших языковых моделей, инференс генеративных моделей, мультимодальные системы, модели обработки изображений, а также рекомендательные алгоритмы и другие приложения с большим количеством embedding-операций.
Отдельно стоит выделить модели Mixture of Experts. В таких архитектурах разные части входных данных могут направляться к различным экспертным блокам. Это создает сложные коммуникационные нагрузки, и способность эффективно обмениваться данными между ускорителями становится важным условием масштабирования.
Google также указывает на пригодность Trillium для вычислительно интенсивного инференса, включая большие diffusion-модели. В тестах со Stable Diffusion XL компания зафиксировала трехкратное увеличение пропускной способности инференса относительно TPU v5e.
Что означает переход с v5e на v6e для разработчика
С точки зрения разработчика переход на Trillium не обязательно означает полную перестройку проекта. Поддержка существующего программного стека TPU позволяет использовать JAX, PyTorch/XLA и другие инструменты, адаптируя вычисления под новую инфраструктуру. Главная задача заключается уже не столько в переносе модели, сколько в ее оптимизации под изменившееся соотношение вычислительной мощности, памяти и межчипового обмена.
Модели, которые раньше упирались в недостаточную вычислительную мощность, получают возможность обучаться быстрее. Модели, ограниченные объемом памяти, выигрывают от увеличенной HBM. Распределенные задачи получают преимущество от более быстрой ICI. Embedding-интенсивные системы могут использовать возможности третьего поколения SparseCore. Таким образом, одна и та же аппаратная платформа может ускорять разные классы приложений благодаря разным компонентам архитектуры.
Почему Trillium важен для дальнейшего развития ИИ
Появление Trillium отражает более общий переход в индустрии от универсальных вычислений к специализированной инфраструктуре искусственного интеллекта. Современная нейросеть требует не просто быстрого процессора. Ей нужна система, в которой вычислительные блоки, память и сеть сбалансированы между собой.
Увеличение количества параметров моделей продолжает повышать требования к вычислительной инфраструктуре, но простое увеличение размера модели имеет физическую цену. Необходимо хранить больше данных, быстрее передавать их между узлами и эффективнее расходовать электроэнергию. Поэтому архитектуры вроде Trillium развиваются одновременно в нескольких направлениях: растет вычислительная плотность, увеличивается объем и скорость памяти, совершенствуются межсоединения и появляются специализированные блоки для отдельных классов нейросетевых операций.
В этом контексте переход от TPU v5e к Trillium нельзя описывать только как очередное увеличение скорости процессора. Google изменила практически весь вычислительный баланс платформы. Пиковая производительность выросла в 4,7 раза, HBM и ее пропускная способность увеличены вдвое, ICI также получил двукратное увеличение, появился SparseCore третьего поколения, а энергоэффективность, по данным Google, выросла на 67 процентов.
Итог: в чем заключается преимущество TPU v6 Trillium
Главное преимущество Trillium заключается не в одной рекордной характеристике, а в согласованном улучшении нескольких уровней архитектуры. По сравнению с TPU v5e шестое поколение получает значительно более высокую вычислительную мощность на чип, вдвое больший объем HBM и удвоенную пропускную способность памяти, вдвое более быстрый межчиповый обмен и специализированный SparseCore третьего поколения. В реальных тестах Google это выражается более чем четырехкратным приростом производительности обучения ряда моделей и до трехкратным ростом пропускной способности инференса в отдельных сценариях.
При этом Trillium показывает, каким становится современный ИИ-ускоритель. Это уже не просто мощный специализированный процессор, а элемент масштабируемой вычислительной системы, включающей память с высокой пропускной способностью, специализированные блоки, высокоскоростные межсоединения, компиляторы и распределенное программное обеспечение. Такой подход позволяет использовать десятки тысяч ускорителей как единую инфраструктуру для обучения и обслуживания моделей, которые невозможно эффективно запускать на небольшом количестве универсальных процессоров.
Таким образом, переход от TPU v5e к TPU v6e Trillium представляет собой не косметическое обновление поколения, а серьезное изменение вычислительной платформы. Рост скорости, памяти, коммуникационной способности и энергоэффективности направлен на одну общую цель — сделать обучение и эксплуатацию все более крупных моделей искусственного интеллекта быстрее, масштабируемее и экономичнее. Именно сочетание этих факторов определяет практическое значение Trillium для современной инфраструктуры ИИ.